FIELD NOTE
放进去不等于用上了:长上下文模型为何会迷失在中间
从 U 形位置曲线、注意力竞争与内部位置偏差出发,解释长上下文模型为何容易忽略中间信息,以及 Agent 和 RAG 应如何重排、压缩并回查证据。
把更多资料放进上下文窗口,大概是普通用户增强模型最直观的方式。窗口从几千 token 涨到几十万,提示词设计和成本模型都在跟着变,但有一个默认假设很少被检查:放进去的信息,回答时真的会被用到吗?
上下文里只有一段内容与问题相关时,把它放在开头或结尾,回答质量往往好于放在中间。这条 U 形曲线是长上下文模型最著名的现象之一——Lost in the Middle——的轮廓。信息明明还在窗口里,为什么没有进入答案?
窗口里的“好位置”:U 形曲线的实验证据
U 形曲线的原始证据来自 Liu 等人的论文 Lost in the Middle,发表于 TACL 2024(原文)。他们用两类任务做位置控制实验:多文档问答与 key-value retrieval。
多文档问答的上下文里排着一组文档,只有一篇包含答案;key-value retrieval 的上下文是一串键值对,目标对藏在不同位置。研究者移动目标内容的位置,其余内容保持不变,观察模型表现如何变化。
在原始实验的多种模型上,这两类任务往往呈现 U 形:目标内容在开头或结尾时表现较好,越靠近中间,表现越容易下降。
这个结果需要用更严格的语言重述:上下文窗口只是“可访问范围”,窗口变长不等于每一段内容都能被均匀、可靠地使用。本文用“有效上下文”指代实际能被模型稳定利用的那部分。
这条曲线有明确的边界。不同任务对位置的敏感程度不同;曲线形状也会随模型、训练时使用的上下文长度和提示结构而变化。这里说的位置,是 token 在输入序列中的位置,与页面排版无关。
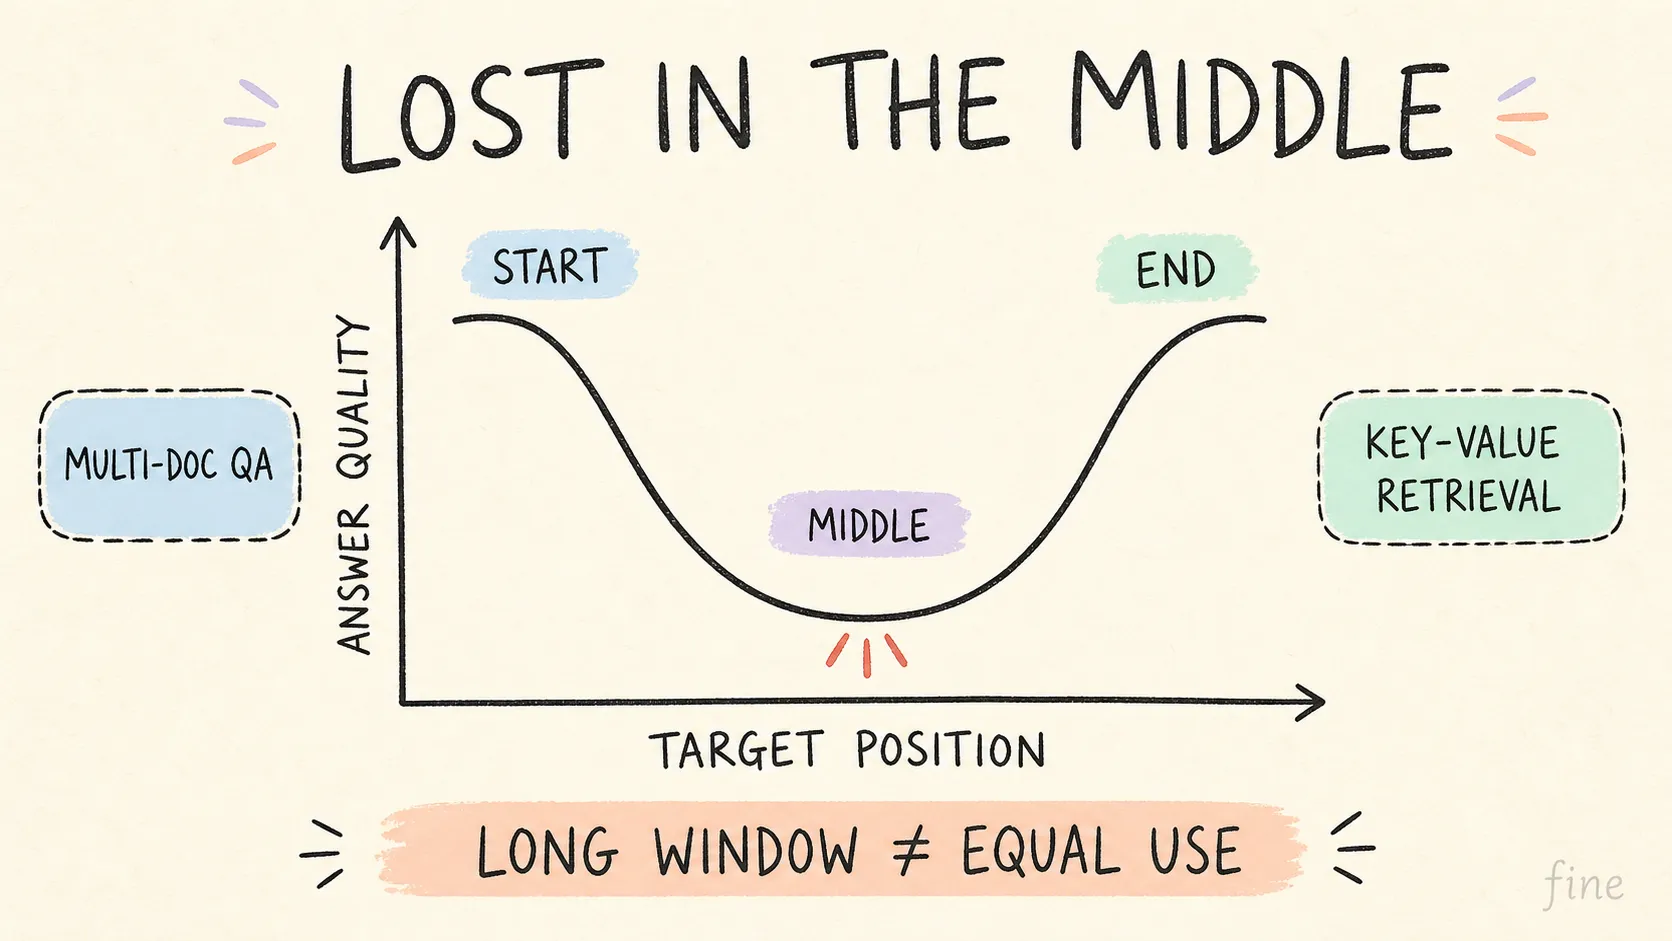
定性 U 形位置曲线:目标信息位于开头或结尾时答案质量较高,位于中间时较低;这是位置效应的示意轮廓,具体形状随任务、模型与提示结构变化。
生成下一个词时,历史信息在竞争什么
Decoder-only 模型每生成一个 token,都要通过多层、多头注意力,从历史表示里寻找与下一个词相关的信息。位置偏好就在这一轮轮选择中积累,最终表现为回答质量的位置差。
结尾首先拥有距离优势。Next-token 训练让模型大量学习局部依赖:紧邻的上文通常更有助于预测下一个词。推理时,答案位于整个输入之后,靠近上下文末尾的内容也离当前生成位置更近,因此更容易被利用。
这是原论文讨论的一种解释,还不是适用于所有模型和任务的普遍定律。
开头的优势来自另一组因素。标题、任务描述和系统指令经常出现在序列开头,序列边界本身也可能成为模型学习到的特殊位置。
与此相关,Xiao 等人在 StreamingLLM 的研究(论文)中发现,模型会把不成比例的注意力分配给序列最初的 token,即使它与当前内容没有明显语义关联。他们将这种现象称为 attention sink。
Attention sink 可能参与形成开头优势,但不能直接等同于 Lost in the Middle 的首因效应:前者主要涉及最初几个 token,后者测量的是开头一整块内容的利用效果,两者并不处在同一尺度。
中间位置同时缺少这两种便利:它离当前生成位置较远,又不处于序列边界。
但不能把这个现象解释成“模型需要穿过更多中间文字”。自注意力会并行比较历史位置;目标放在中间时,候选内容总数与放在两端时相同。
目前没有一个得到普遍确认的单一根因。因果生成带来的局部性、训练数据中的位置先验、位置表示方式、训练时采用的上下文长度,以及模型内部与位置相关的注意力偏差,都可能参与形成这条 U 形曲线。
“注意力总量有限”是什么意思
一个常见误解,是把 softmax 归一化理解成整个模型只有一桶固定的注意力。
准确地说,单个注意力头在某个 query 位置上,会为所有历史位置分配一组权重,这些权重之和为 1。不同层、不同注意力头各自计算,并不共享一个全局预算。
可以用一个纯数学例子理解竞争为何会随上下文增长:
- 10 个候选得分相同时,每个占 10%
- 1000 个候选得分相同时,每个只占 0.1%
真实模型给不同位置的分数当然不会相同。但随着候选增加,某条关键信息必须表现得更加突出,才能获得足以影响输出的权重。
这只能解释长上下文为什么让信息竞争变难,不能单独解释为什么中间位置最差。U 形位置偏差还需要前面提到的局部性、边界先验和位置表示等因素共同解释。
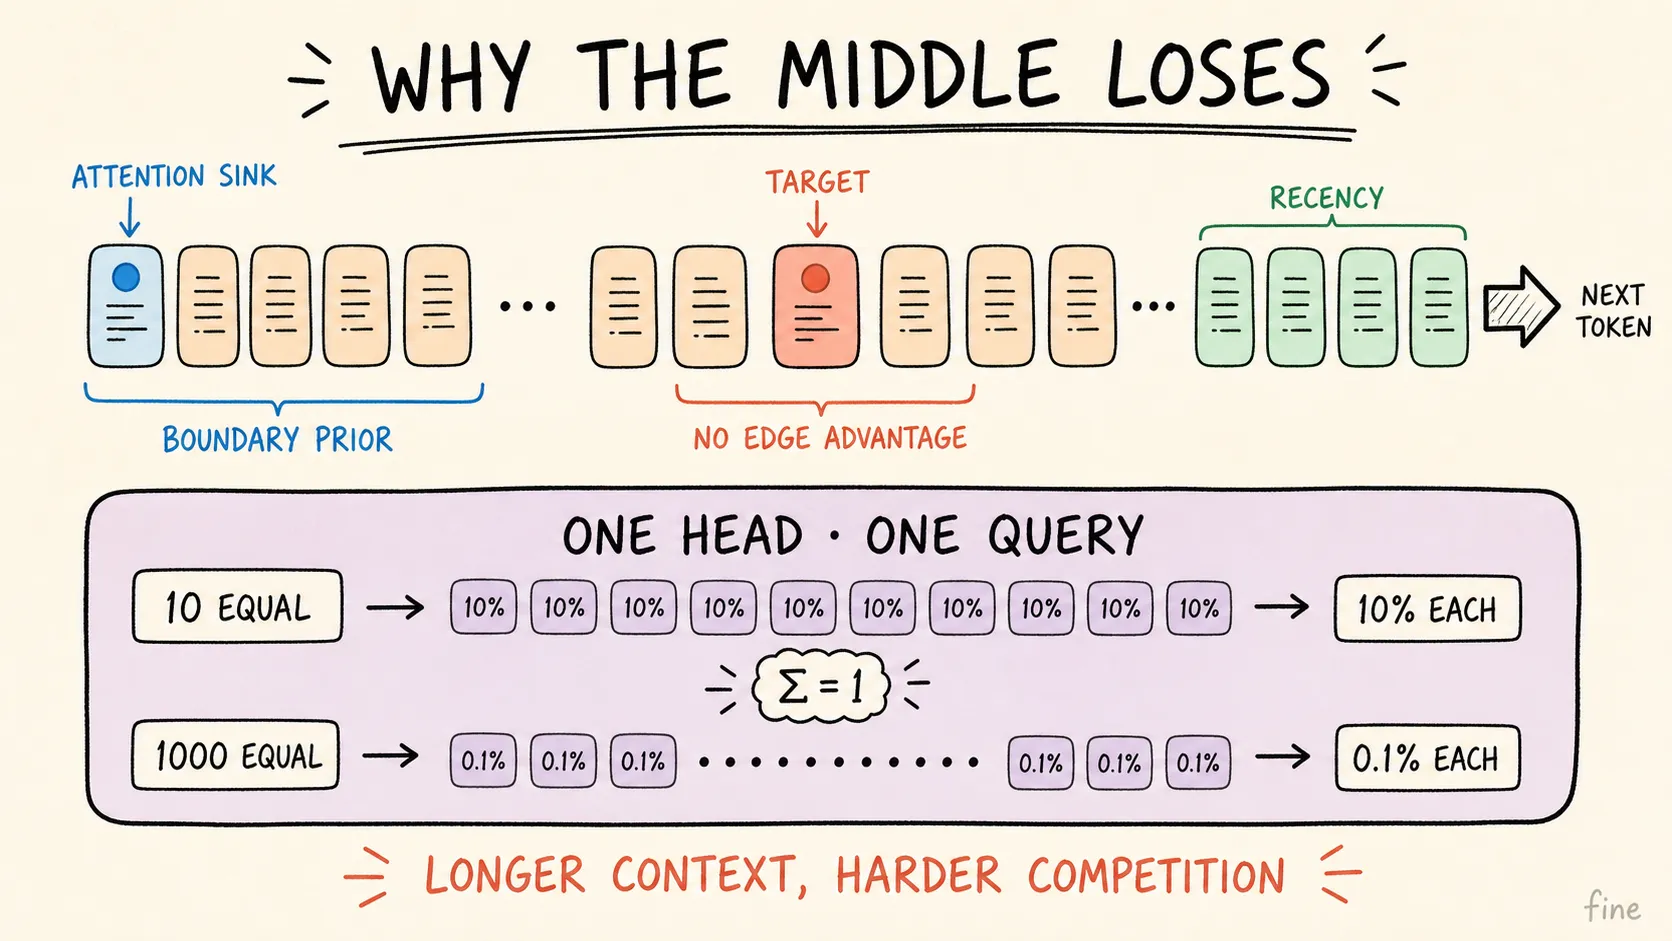
两件常被混为一谈的事:上下文两端的位置便利,以及单个注意力头、单个 query 下 softmax 权重和为 1 的归一化竞争。后者能解释长上下文为何竞争更难,却不能单独解释 U 形曲线。
读到了,不等于用到了
信息还可能通过第一道关,却倒在第二道关。
Gao 等人的论文 Insights into LLM Long-Context Failures: When Transformers Know but Don’t Tell(原文)使用探针分析模型的隐藏表示。他们发现,从中间层表示中有时可以识别目标信息所在的位置,但模型最终仍没有生成正确答案。
换句话说,模型内部可能“知道去哪里找”,却没有成功把这份信息用于输出。定位信息和利用信息,是两道不同的关。
Hsieh 等人在 Found in the Middle(原文)中进一步观察到,文档获得的注意力分数会被其位置系统性地扭曲:即使相关性不变,开头和结尾的文档也更容易获得较高注意力。
他们先用参考文档估计位置带来的注意力偏差,再从实际文档的注意力分数中校准掉这部分偏差,将校准后的结果用于相关性排序和 RAG。实验表明,这类方法可以改善中间信息的利用,但还不足以把所有位置拉到完全相同的水平。
输入侧的补救也有边界。
Liu 等人在原始论文中,把查询同时放在整组资料的前后,让文档或键值对在编码时能够接触查询。结果在简单的 key-value retrieval 上接近完美,位置差几乎消失;在复杂的多文档问答中,改善却很有限,U 形趋势仍然存在。
同一种改动在两类任务上效果悬殊,说明“找到目标”与“理解并使用目标”不是同一难度。
把位置偏好写进 Agent 和 RAG 的设计
先决定放在哪里
检索结果不宜按搜索引擎返回的顺序直接塞进窗口。系统可以先按相关性重新排序,把最可能包含答案的材料放在更有利的位置。
开头和结尾谁更好,没有适用于所有模型的固定答案。更稳妥的做法是保持相关性优先,并针对实际模型测试不同排列。
当前步骤强依赖的约束——格式要求、事实前提、安全条件——可以保留在系统提示中,或在关键决策前重新带到当前轮次附近。窗口装不下时,应按相关性截断,优先删除低价值材料,而不是机械地保留两端。
控制放进去多少
工具日志、重试记录和任务中间摘要不断追加,会逐渐形成大量低信噪比内容。它们不一定完全无用,却会增加关键信息需要面对的干扰。
更合适的方式是先做摘要或结构化压缩,再把结果放回工作上下文。
长期记忆、工作记忆和原始日志也不必堆在同一个窗口里:
- 长期记忆保存经过沉淀的事实、结论和稳定偏好
- 工作记忆保存当前任务直接需要的材料
- 原始日志留在外部,需要核查时再展开
分层以后,窗口中的每一段内容都有明确用途,原始细节不会长期占据高价值位置。
在关键决策前重新回查
隐藏表示里能够定位的信息,并不会自动进入答案。因此,在 Agent 调用工具、提交操作或给出最终结论前,可以显式增加一次证据回查。
这一步重新取得与当前判断直接相关的原文片段,把它放到靠近生成位置的地方,再要求模型基于证据作答。信息利用从一次隐式期待,变成了明确的执行步骤。
Query-aware contextualization 提供了一部分旁证:在简单检索任务中,让查询参与资料编码,几乎可以消除位置差;但它在多文档问答中的收益有限,因此仍不能充当普适方案。
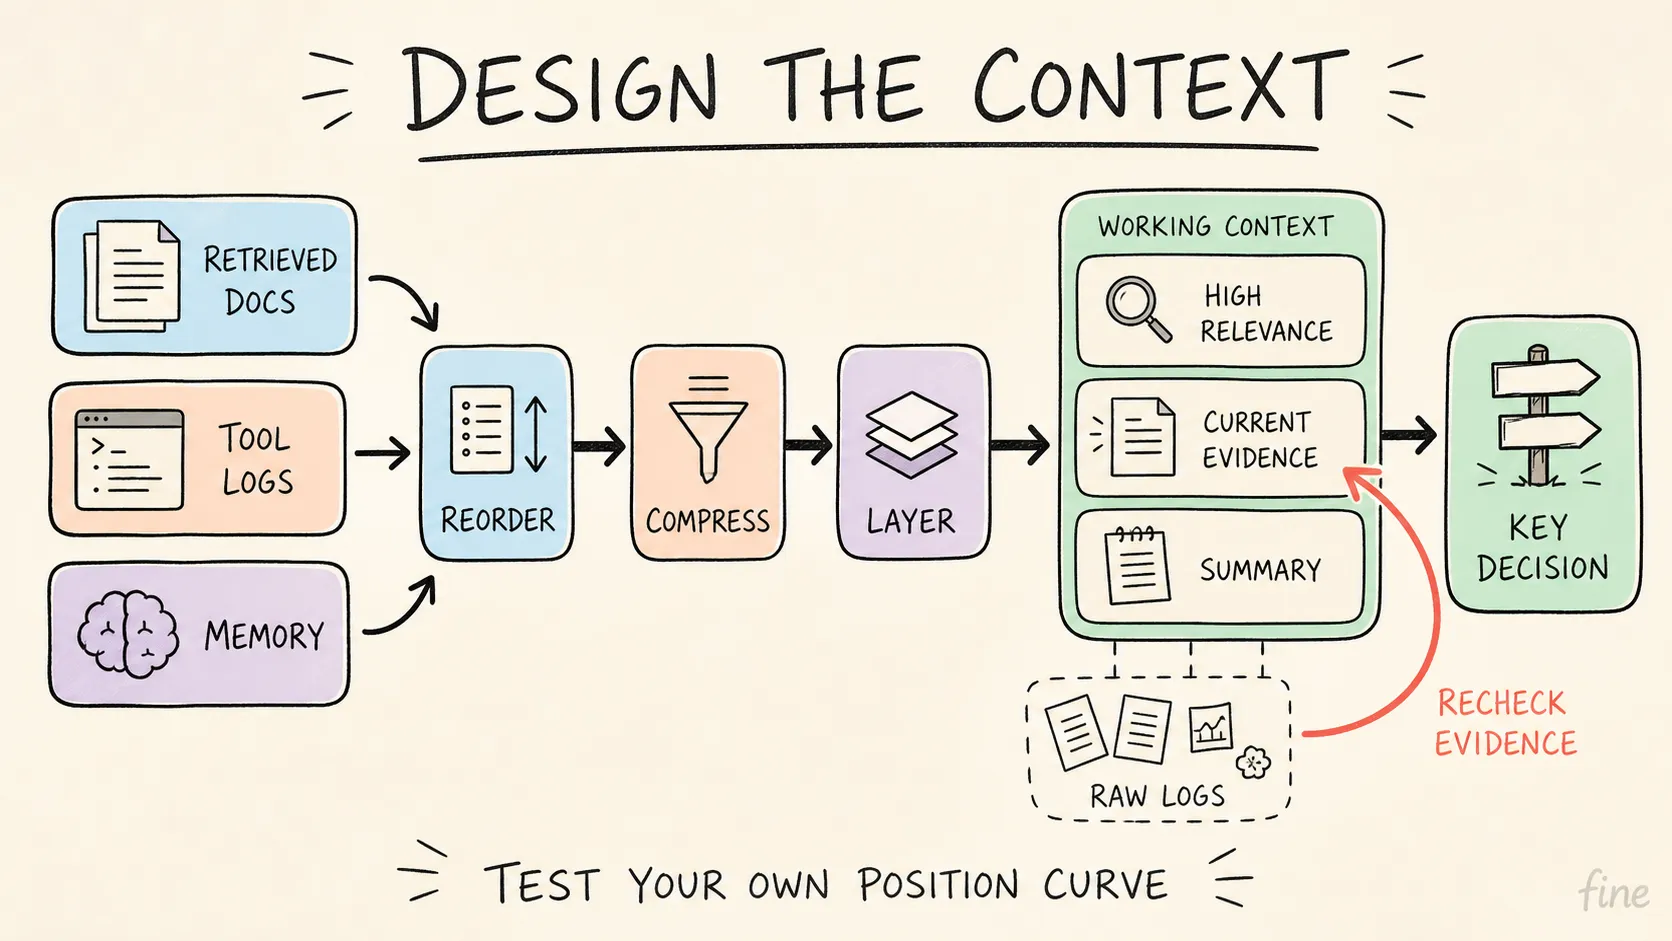
Agent/RAG 的上下文处理顺序:重排、压缩并分层组织工作上下文,关键决策前回查外部保留的原始证据,而不是让原始日志长期占据窗口。
具体到自己的系统,“怎么放”没有固定答案,但验证方法可以固定下来:选一个真实任务,保持检索内容和目标答案不变,把目标材料分别放在开头、中部和结尾,各运行多轮,画出自己的位置曲线。
然后继续测两件事:关键内容离当前生成位置多远时仍能稳定生效,以及加入多少低信噪比日志后回答质量开始下降。这条实测曲线,才是重排、压缩和回查策略的设计依据。
DISCUSSION
评论
正在加载评论…