FIELD NOTE
Uncle Bob 的多 Agent 流水线:从 Prompt 规则到确定性工具
拆解 Uncle Bob 的 Specifier、Coder、Cleaner、Hardener 与 QA 流程:用短上下文分工,用 CRAP、变异测试和端到端脚本把质量规则变成可执行门禁。
Robert C. Martin(Uncle Bob)在一次访谈里讲了他如何组织多 Agent 流水线。他先注意到一个现象:Agent 生成的代码同样会被脏代码拖住,修一处坏一处,有时在同一个问题上循环打转。代码自己不会觉得脏,但它会成为下一轮改动的输入,复杂度到那时才现形。
Bob 原本靠代码审查对付这类问题,Agent 出活的节奏让他没法继续逐行看。他把早年为人类代码准备的检查工具重新搬出来,用在 Agent 的产出上:CRAP 分析把测试覆盖率和圈复杂度合成一个分数,标出覆盖率低且复杂度高的区域;变异测试故意翻转符号、颠倒条件,批量制造实现变体,看测试能不能真的拦住。这两项检查在流水线里分别由 Cleaner 和 Hardener 执行。
Bob 把这些描述为个人实践,没有把效率判断包装成经过对照实验验证的结论;更值得关注的,是他如何把软件质量从 Prompt 里的愿望,变成流水线里的门禁。
Prompt 规则为什么靠不住
Bob 起初想用 Prompt 管住 Agent 的质量。他给 Agent 写过一份很长的文档,把 Clean Code、TDD 和代码规范都写进去,结果模型把它们当成加勒比海盗式的指导意见:每条听起来都像规矩,却都可以被灵活绕过。
他用 lost in the middle 解释这个现象:长上下文的中间部分更容易被模型忽略,写在手册后段的规则,模型可能根本不记得。文档再长,模型也没有机制保证逐条执行;它可能当场遵守,换个会话就忘掉。上下文一长,规则能不能被看见本身就不可靠。
于是他把方案反过来:初始 Prompt 尽量短,只交代任务本身;质量检查从劝 Agent 遵守,挪进确定性工具。工具不看上下文、不做解释,只返回通过或不通过。不合格就让 Agent 在当前检查中循环修改,直到符合标准。此后他对 Agent 的期待只剩一个:把任务做出来,做得好不好由工具说了算。
五个角色的验证流水线
按验证的推进顺序,可以把流水线分成五个环节:需求转化、实现、代码质量、测试强度、系统验收。Bob 本人未必这样划分;这样分,只是为了看清每一层验证的是什么。
Human request → Specifier → Coder → Cleaner → Hardener → QA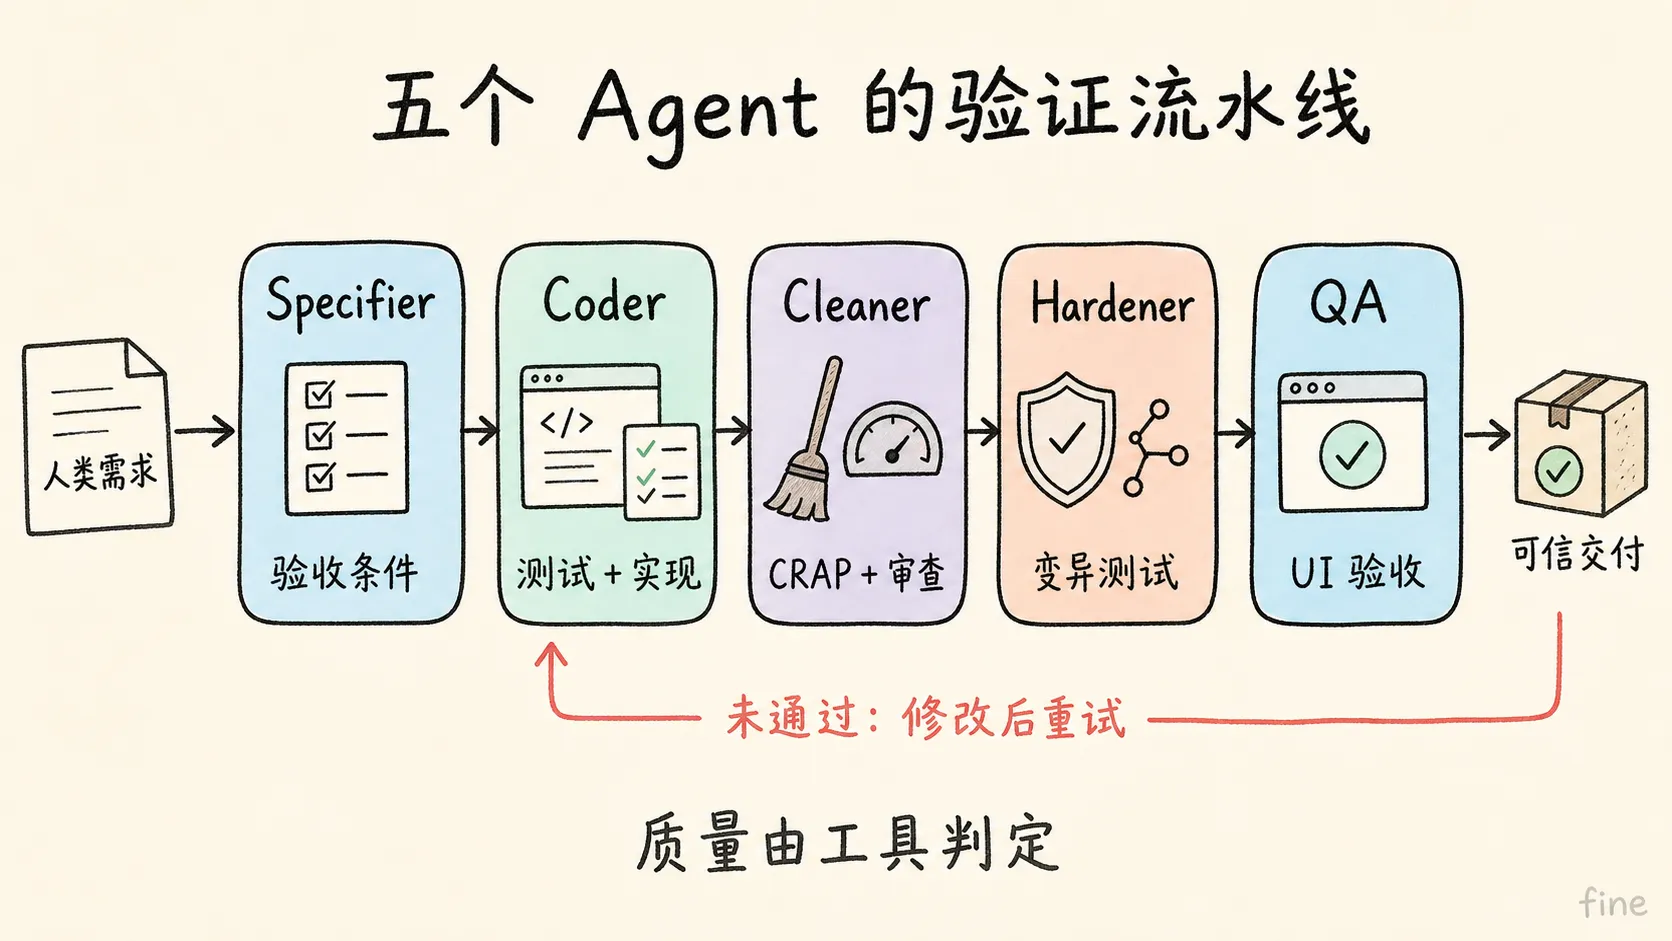
这张图帮助读者建立五个 Agent 的分工顺序与反馈关系:需求先转成验收条件,再依次经过实现、代码质量、变异测试和 UI 验收,未通过的产出会送回 Coder 重试,整体质量由工具判定。
流程的前半段处理需求和实现。Specifier 接收一段自然语言需求,改写成两份文档:Gherkin 格式的 Given/When/Then 验收条件,以及一份从真人操作 UI 的角度写成的 QA procedure。需求在这里第一次变成可以由机器判定的断言,后面所有环节都以它为基准。
需求理解上的偏差往往藏在这一步:模型可能交出一份结构完整的代码,实现的却是它自行推断的那份需求。Specifier 的改写迫使需求先落成断言,再进入实现。需求本身仍由人写,Specifier 只负责转换;验收条件一旦落定,后续角色的工作范围也被框住了。
Coder 接手写单元测试和实现,让 Gherkin 验收条件通过。验收条件会被工具真实运行,通过与否不靠 Agent 口头汇报。到这一步,代码行为是否满足需求,有了运行结果上的确认。
功能满足需求,代码不一定干净。Cleaner 负责质量这一环:运行前文提到的 CRAP 分析,再做常规代码审查,处理实现阶段留下的混乱。CRAP 这类质量阈值由 Bob 亲自决定;他不逐行读代码,靠这类指标把风险区域筛出来。同样是 CRAP 分数,不同项目会有不同标准。
测试能通过、代码也干净了,还要确认测试本身够不够强。Hardener 运行变异测试,故意翻转符号、颠倒条件,制造大量实现变体。某个变体没有被测试拦住,就产生一个存活变异体,说明测试没有真正抓住那个行为。Hardener 对存活变异体把关很严,这是对测试强度的硬性检查。
最后是 QA。QA Agent 把书面的 QA procedure 转成可执行脚本,通过 UI 操作系统,检查确定性结果。单元测试和变异测试都只作用于代码内部,这一环补上真实用户路径上的端到端行为。
短上下文与上下文轨迹
为什么不让一个 Agent 从头干到尾?角色拆分有两类价值。其一是并行,多个 Coder 可以同时处理不同任务。其二是聚焦,每个角色只做一件事,做完就退出,下一个角色在干净的上下文里重新开始。既然规则在长上下文里会丢,缩短上下文本身就是应对办法。多 Agent 在这里的意义,是用可验证的方式把写代码和证明代码这两件事分开。
同场对谈的 Matt Pocock 补充了另一个角度:同一个会话存在上下文轨迹,前一个阶段形成的行为倾向会延续到后面的判断。把环节拆开,等于在轨迹中间切一刀,行为倾向随会话一起结束。这是 Matt 的观察;角色之间具体传递哪些信息,Bob 没有展开讲。照这个说法,拆角色的收益不只是上下文更短,还切断了行为倾向的延续。
代价也是真实的:每个 Agent 启动、重新理解需求、交接都会增加开销。Bob 接受这些成本,他的衡量标准是整条链路最终能不能交出可信结果。
架构和规划仍是人的事
在这条流水线里,Bob 的工作变成写初始需求、决定质量阈值、查看质量指标、抽查代码、检查系统外围。抽查依然必要,但范围小得多:工具已经过滤掉明显的问题,人只需要看关键路径和可疑区域。让 Bob 放心的是,这些检查真实发生过,而不只是某个 Agent 说了一句“做完了”。
这条流水线的边界也很清楚:它解决的是既定标准如何执行,不能替人决定系统应该怎样组织。Bob 用架构查看器观察模块与依赖,也用确定性规则文件检查哪些依赖被允许、哪些被禁止。合理的模块边界主要是人工判断,由他亲手处理;确定性规则文件能拦住不该出现的依赖,回答不了什么样的模块划分是好的。让 Agent 自动化地组织架构,他试过,效果不好。
他对大型前置规划的态度印证了同一条边界。他试过把计划写得很长很细,执行中仍发现计划不适用。所以他一次只做一两个 story,观察结果,必要时人工整理架构,再继续。规格在这里是临时的,是下一轮工作的起点,系统长成什么样,由人在过程中逐步决定。
这套流程可复用的部分,是把需求转化、实现、清理、加固、验收拆成短上下文的环节,并用外部工具做确定性检查。工具负责执行已经定义的标准,人仍然要对需求、阈值和系统形态做判断。
本文依据 Uncle Bob 的原始访谈视频中关于 Agent 开发流程的部分整理。角色与工具来自 Robert C. Martin 的个人实践;“上下文轨迹”的说法由主持人 Matt Pocock 在对谈中提出。
DISCUSSION
评论
正在加载评论…